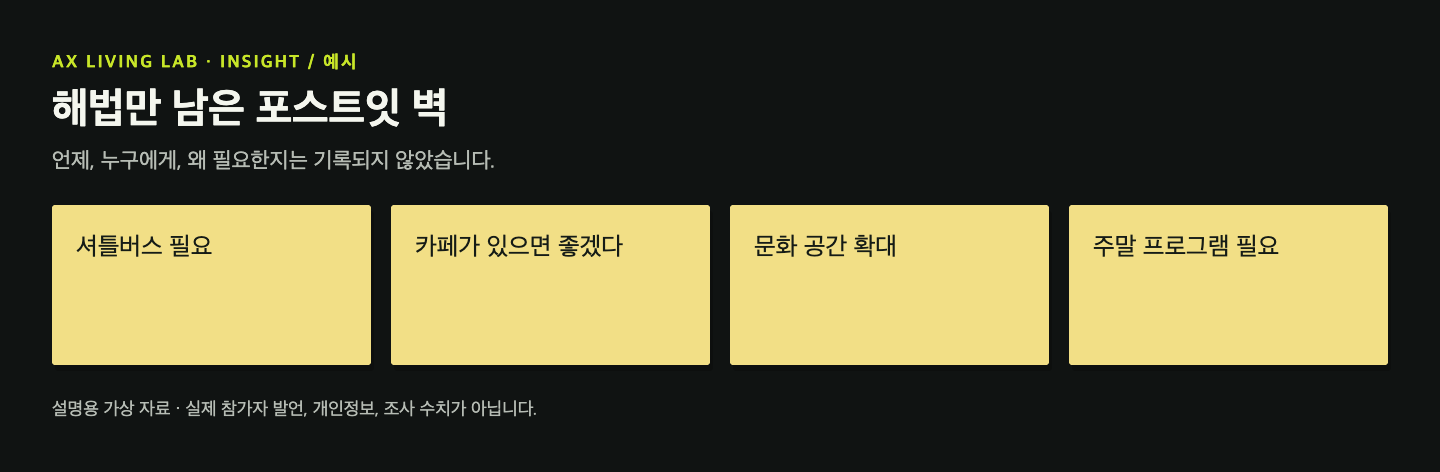
워크숍에서 “셔틀버스가 필요하다”는 제안이 나왔습니다. 다음 회의에서는 어떤 근무조의 귀가 문제인지, 이동 시간과 비용 중 무엇이 문제인지 다시 묻게 됩니다. 아이디어는 남았지만, 그 아이디어를 판단할 경험과 맥락이 함께 남지 않은 상황입니다.
정리의 목표는 아이디어 목록을 줄이는 데 그치지 않습니다. 어떤 경험에서 나온 제안인지, 어떤 사용자 니즈를 해결하려는지, 무엇을 더 확인해야 하는지 연결해 다시 활용할 수 있어야 합니다. 이를 위해 리서치 리포지터리, 즉 리서치 자료 저장소의 구조부터 정합니다. AI가 분석할 수 있도록 현장 기록을 수집·구조화하고, 사람이 역할을 나눠 해석 후보를 검수·구체화하는 방식으로 현장 활동을 역으로 설계합니다.
핵심 원칙: AI 분석의 출발점은 현장의 수집 규칙입니다. 포스트잇의 색·위치·참가자 번호와 경험의 맥락을 함께 남겨야 합니다. 기록하지 않은 맥락을 AI가 추정해도 조사 근거가 되지는 않습니다.
이 글은 문화선도산단 청년디자인리빙랩 자료를 검토하며 정리한 저희의 실무 설계 제안입니다. 정성조사와 워크숍 기록을 다루며, 효과가 검증된 운영 모델을 제시하는 것은 아닙니다. 이미지와 아래 수치는 모두 가상 예시입니다.
1. 목표: 경험에서 니즈와 인사이트까지 근거를 연결합니다
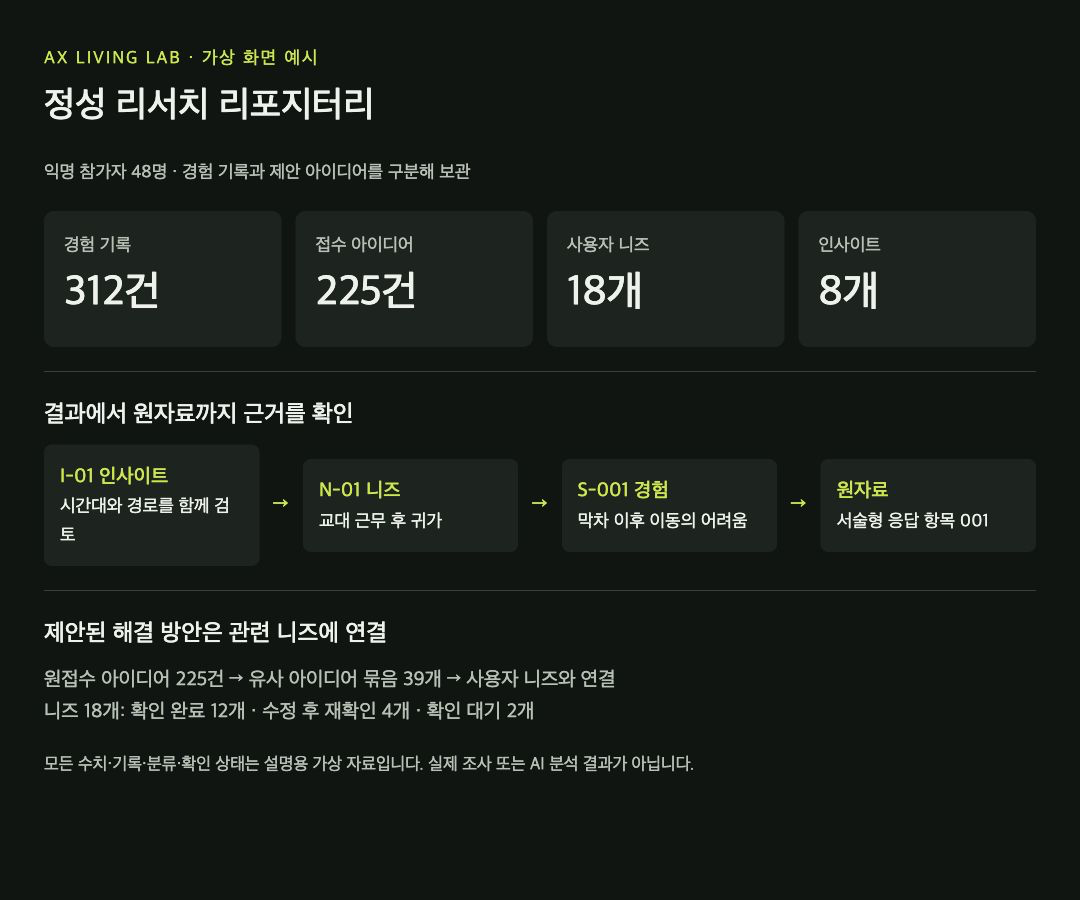
리포지터리는 경험 기록·사용자 니즈·아이디어·인사이트를 출처와 함께 연결해 보관하는 방식입니다. 보고서를 만드는 데 필요한 자료이자, 다음 조사와 서비스 설계에서 다시 확인할 수 있는 근거입니다.
| 구분 | 의미 | 반드시 연결할 것 |
|---|---|---|
| 경험 기록 | 참가자의 발언·서술형 응답과 현장 관찰 | 익명 참가자 번호, 상황, 원자료 위치 |
| 사용자 니즈 | 특정 상황에서 사용자가 충족하려는 요구 | 관련 경험, 상반된 경험, 참가자 확인 의견 |
| 아이디어 | 문제를 해결하기 위해 제안한 방안 | 제안 원문, 유사 아이디어 묶음, 관련 니즈 |
| 인사이트 | 경험의 패턴과 원인을 해석해 도출한 설계 방향 | 관련 니즈, 근거와 반례, 적용 조건, 추가 질문 |
예를 들어 “막차 이후 귀가가 어려웠다”는 경험, “늦은 퇴근에도 감당할 수 있는 비용으로 귀가하고 싶다”는 니즈, “공동 차량을 운영하자”는 아이디어입니다. “교통수단의 유무뿐 아니라 근무 시간과 이용 비용을 함께 봐야 한다”는 문장은 근거를 대조하며 검토할 인사이트 가설입니다.
이 네 가지를 한 문장으로 합치지 않습니다. 같은 니즈에 여러 아이디어가 연결될 수 있고, 하나의 인사이트가 여러 니즈를 설명할 수도 있습니다. 아직 경험 근거가 없는 아이디어는 삭제하지 않고 ‘근거 확인 필요’로 남깁니다.
가상 화면에서는 경험 기록 312건에서 니즈 18개와 인사이트 8개를 도출하고, 별도로 접수한 아이디어 225건을 유사 아이디어 묶음 39개로 정리했습니다. 아이디어를 니즈로 압축한 비율을 뜻하지 않습니다. 두 자료의 관계를 연결한 예시입니다. ‘니즈 확인 완료 12개’ 역시 검증 횟수가 아니라, 전체 18개 중 참가자가 해석을 확인한 니즈 수입니다.
경험 기록 → 사용자 니즈 → 인사이트 / 접수 아이디어 → 유사 아이디어 묶음 → 관련 니즈와 연결
2. 문제: 아이디어만 모으면 경험과 맥락이 사라집니다
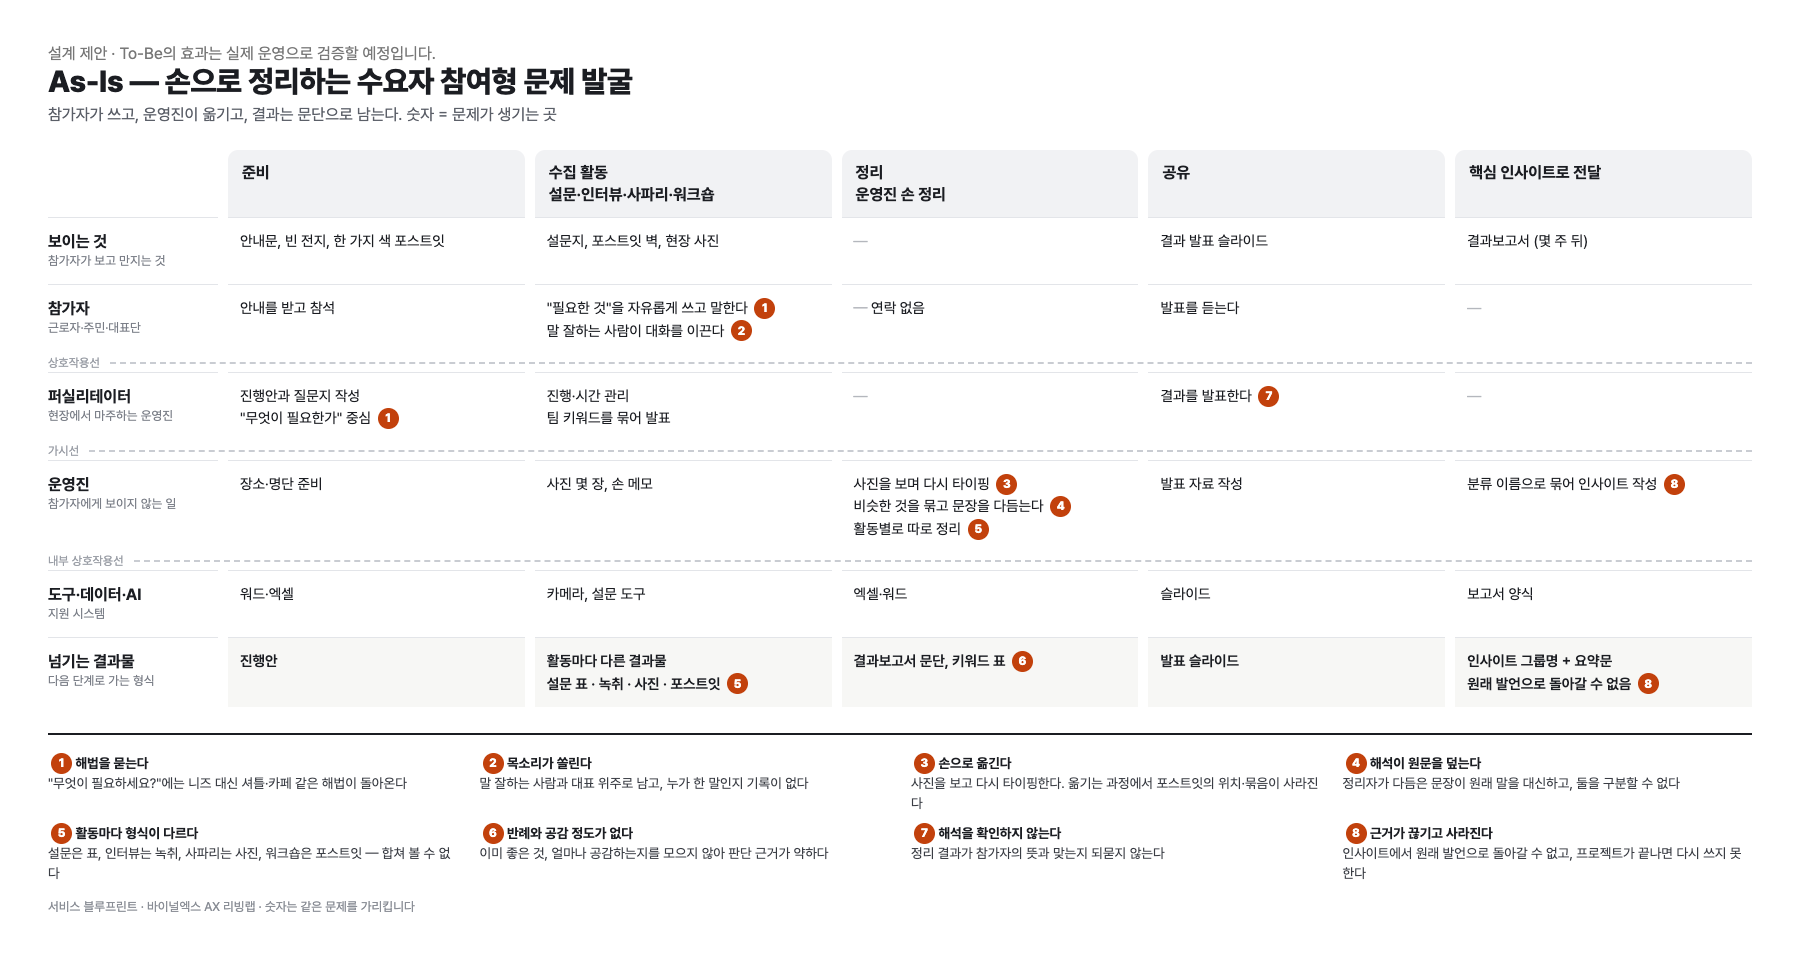
리포지터리의 구조가 정해지면 기존 정리 방식도 구체적으로 점검할 수 있습니다. 아래 여덟 가지는 모든 워크숍에 대한 일반화가 아니라, 저희가 사용하는 실무 점검 항목입니다.
| 문제 | 정리 후 남는 공백 |
|---|---|
| 1. 해법부터 묻는다 | 제안한 방안은 있지만 해결할 경험이 없습니다. |
| 2. 발언이 일부에게 집중된다 | 누구의 경험이 반영되거나 빠졌는지 알기 어렵습니다. |
| 3. 반례와 공감 범위를 남기지 않는다 | 다른 경험과 참여 범위를 확인할 수 없습니다. |
| 4. 사진을 보며 수작업으로 옮긴다 | 위치·묶음·대화 맥락이 기록에서 빠질 수 있습니다. |
| 5. 해석이 원문을 덮는다 | 참가자의 말과 정리자의 판단이 구분되지 않습니다. |
| 6. 활동마다 기록 형식이 다르다 | 인터뷰·관찰·워크숍 결과를 함께 비교하기 어렵습니다. |
| 7. 참가자에게 해석을 확인하지 않는다 | 잘못 읽었거나 누락한 내용을 수정할 기회가 없습니다. |
| 8. 결론과 출처를 연결하지 않는다 | 인사이트에서 원래 발언으로 돌아갈 수 없습니다. |
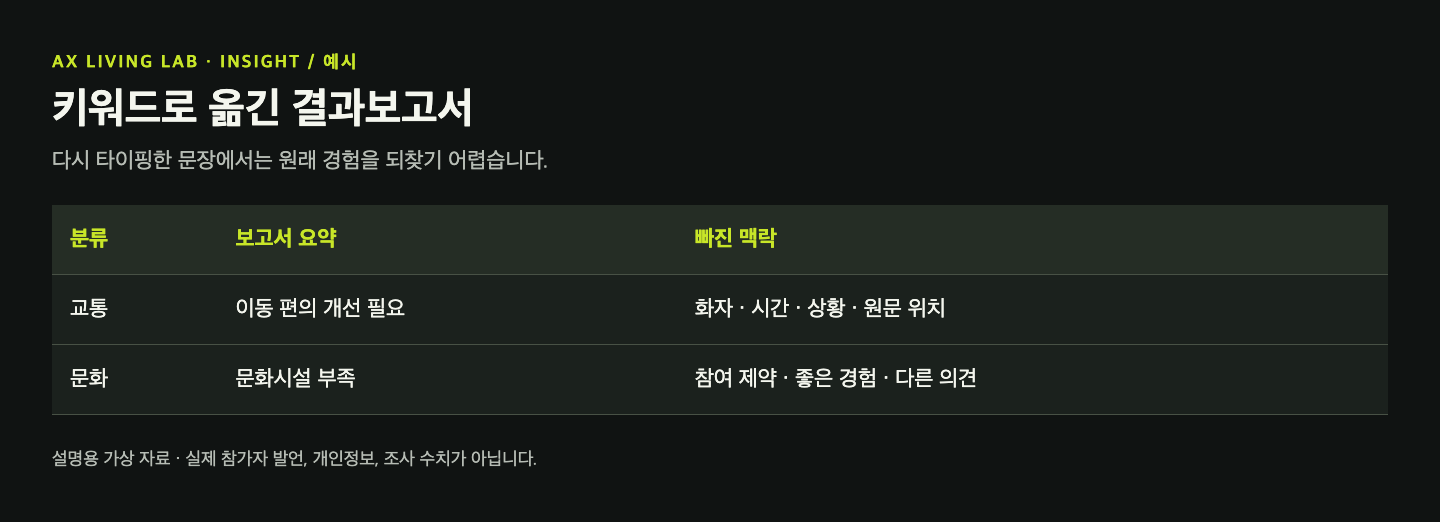
3. 실행: 좋은 분석은 현장의 수집 규칙에서 시작합니다
현장에서는 준비 → 수집 → 신호 원장 → 정리 워크숍 → 인사이트 순으로 진행합니다. 다만 설계할 때는 최종 인사이트에 필요한 근거를 먼저 정하고, 그 근거를 얻을 질문과 활동으로 거슬러 올라갑니다. 아래 설명은 현장 진행 순서로 읽을 수 있도록 배치했습니다. 조사 중 새로운 경험이 나오면 질문과 분류도 수정합니다.
서비스 블루프린트는 참가자에게 보이는 활동, 운영진의 후면 업무, 기록 도구와 AI의 지원을 나눠 보여줍니다. 활동마다 누가 기록하고 확인하며 다음 단계에 무엇을 전달하는지 검토하는 도구입니다.
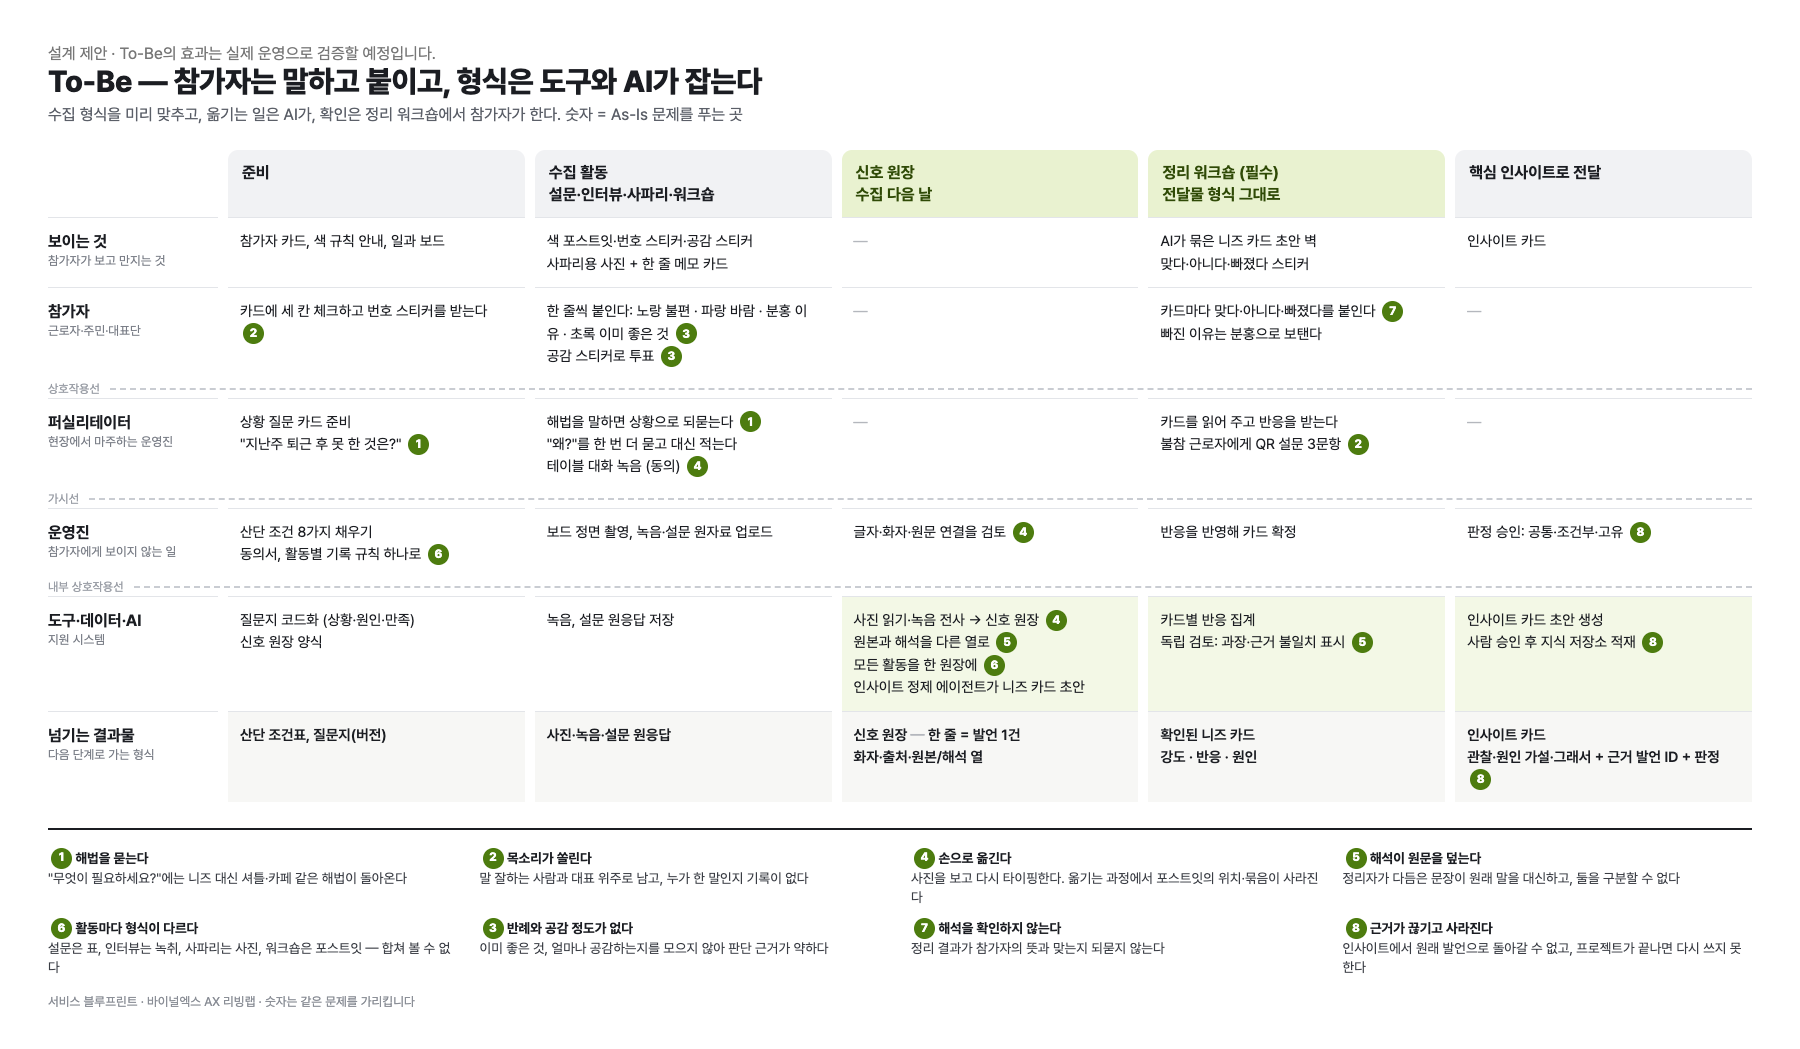
AI를 활용하려면 기록을 옮기는 일뿐 아니라, 분석에 필요한 자료를 만드는 방식도 설계해야 합니다. 원자료·상황·출처를 수집하고, 이를 분류한 자료와 해석 후보를 생성한 뒤, 사람의 검토를 거쳐 구체화합니다. AI가 만든 문장은 원자료와 구분하며 근거로 재집계하지 않습니다.
| 단계 | AI의 역할 | 사람의 역할 | 저장할 자료 |
|---|---|---|---|
| 수집 | 질문·활동지 초안, 사진 판독·음성 전사 | 참가자: 경험 제공 / 현장 조사자: 맥락 보완·원문 대조 | 원문·상황·익명 번호·출처 위치 |
| 분석 자료 생성 | 분류·유사 묶음·복수의 니즈와 인사이트 후보 제안 | 연구자: 분류 기준 설정·근거와 반례 확인 | 후보별 근거·반례·미확인 사항 |
| 검수 | 의견과 이견 정리·근거 연결이 약한 해석 표시 | 참가자: 경험 반영 확인 / 연구자·분야 전문가: 추론과 맥락 평가 | 평가자 역할·평가 항목·이유 |
| 구체화 | 수정안·추가 질문·리포트 초안 | 연구자: 채택·수정·보류 / 서비스 담당자: 후속 과제 선정 | 버전·판단자·수정 사유·후속 과제 |
같은 사람이 여러 역할을 맡을 수 있지만, 어떤 역할로 무엇을 확인했는지는 구분합니다. 현장 조사자는 기록의 품질을, 연구자는 분석의 타당성을, 분야 전문가는 현장 맥락을 검토합니다. 참가자의 경험 확인과 서비스 담당자의 실행 판단도 별도로 남깁니다. 출처 누락·번호 중복·필수 항목은 규칙 기반 도구로 검사합니다.
준비: 경험을 묻고 기록 규칙을 먼저 정합니다
“셔틀버스가 필요하세요?”보다 “최근 귀가가 어려웠던 때는 언제였나요?”로 시작합니다. 의료진의 구체적인 진료 사건을 수집한 중요 사건 기법 연구[3]를 참고한 질문 설계입니다. 좋은 경험도 묻고, 참가자 구성이 어떤 조건을 포함하거나 놓치는지 기록합니다.
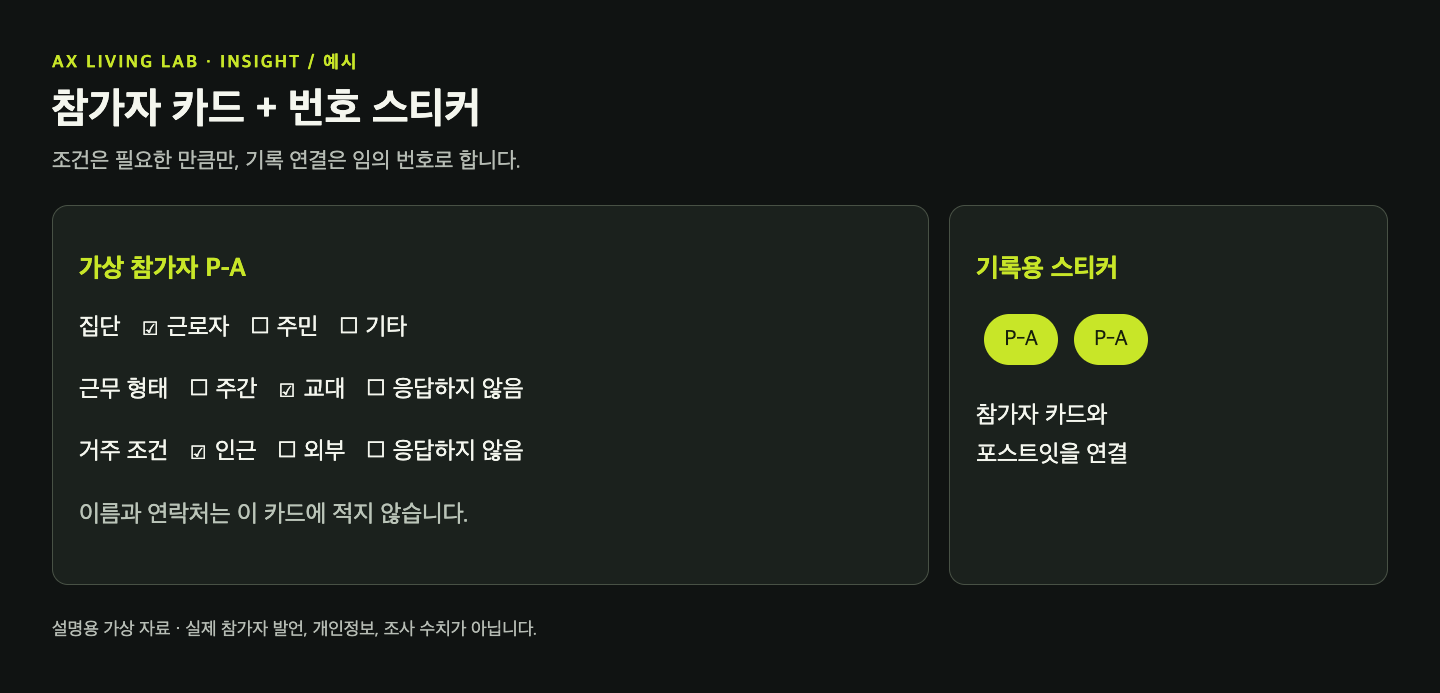
참가자 카드에는 번호와 분석에 필요한 최소한의 조건을 담습니다. 수집·보관·공유 범위와 녹음 여부를 설명하고, 촬영할 게시판과 기록 위치를 미리 정합니다. 참가자는 경험을 말하고 붙이고 표시하며, 진행자가 필요한 맥락을 보완합니다. 자료 저장 형식을 참가자가 직접 작성하게 하지는 않습니다.
AI는 유도 질문 점검과 활동지 초안을 돕습니다. 운영진은 조사 질문·참여 범위·기록 규칙을 정합니다. 이후 확인할 니즈 카드와 인사이트 카드 양식을 먼저 준비하면 수집할 정보도 구체화할 수 있습니다.
수집: 포스트잇의 색·위치·번호·맥락을 함께 남깁니다
활동별 기록은 같은 형식으로 강제하기보다, 원래 형식을 보존하면서 공통 항목으로 연결합니다. 공통 항목은 참가자 번호·상황·경험 또는 제안 원문·출처 위치입니다. 각 활동의 고유한 맥락도 남깁니다.
현장 수집의 다섯 가지 규칙 — 분석이 끝난 뒤 보완할 항목이 아니라, 활동 전에 정할 기준입니다.
- 한 장에는 경험 또는 아이디어 한 건. 서로 다른 경험을 나누고, 해결 방안은 별도 제안 영역에 둡니다.
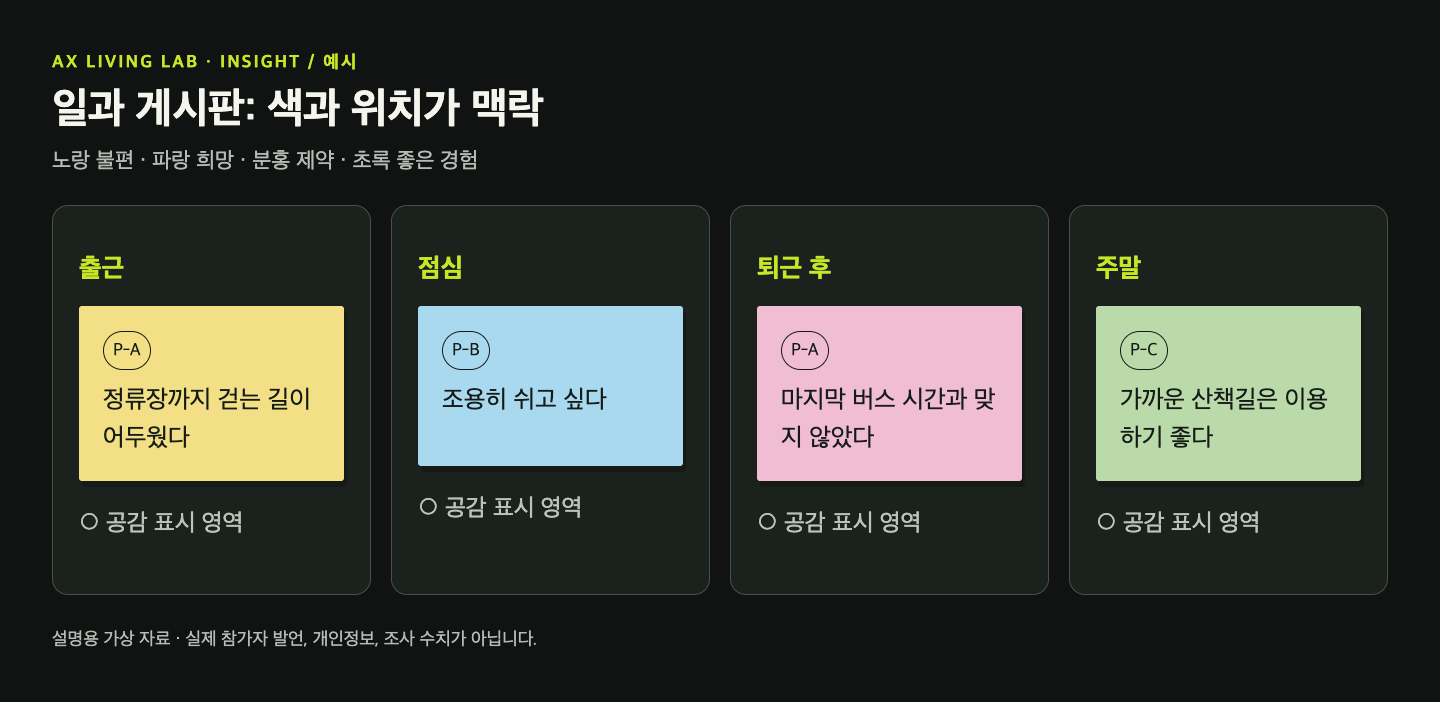
- 색은 기록의 종류. 노랑은 불편, 파랑은 바람, 분홍은 제약, 초록은 좋은 경험으로 구분합니다.
- 위치는 경험의 시간대. 출근·점심·퇴근 후·주말 영역에 붙이고, 사진에는 영역 이름과 게시판 전체가 보이게 남깁니다.
- 번호는 참가자와 원자료의 연결. 포스트잇에 익명 참가자 번호를 붙이고, 기록 번호로 사진 위치·녹음 시각·메모를 연결합니다.
- 맥락과 이견도 기록. “언제, 어디서, 어떻게 대처했나요?”를 묻고 빠진 설명을 보완합니다. 공감·다른 의견과 해당 활동의 참여 범위를 함께 남깁니다.
참가자는 말하고 붙이고 표시합니다. 진행자는 번호·위치·맥락이 빠지지 않도록 운영합니다. 색만 보고 원인을 확정하거나, 공감 표시 수를 전체 사용자의 비율로 해석하지 않습니다.
| 오프라인 활동 | 수집할 내용 | 함께 남길 맥락 |
|---|---|---|
| 심층 인터뷰·서술형 질문 | 구체적 사건, 불편, 대처, 바람 | 질문, 발생 상황, 발언자, 녹음 시각 |
| 서비스 사파리·현장 관찰 | 이용 행동과 환경, 참가자의 설명 | 장소, 관찰 시점, 사진, 사실과 해석 구분 |
| 일과·경험 여정 워크숍 | 시간대별 경험과 제약, 좋은 경험 | 게시판 위치, 참가자 번호, 공감·이견 범위 |
| 아이디어 발산 워크숍 | 제안한 해결 방안과 제안 이유 | 제안자, 관련 경험·니즈, 원접수 번호 |
수집 예시: 색으로 종류를, 위치로 시간대를, 번호로 참가자를 구분합니다
관찰 예시: 본 사실과 참가자의 설명, 조사자의 해석을 나눕니다
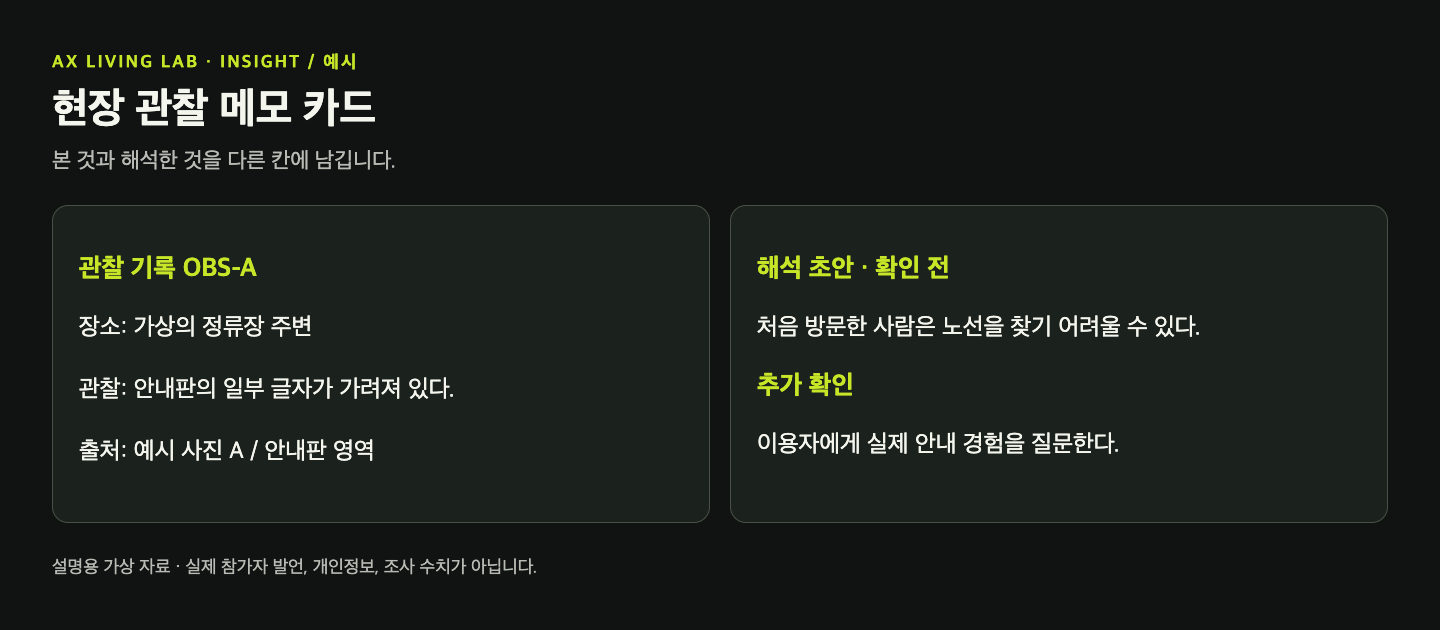
AI는 사진의 글자·색·위치 읽기와 녹음을 글로 옮기는 일을 보조합니다. 사람은 발언자·부정 표현·읽히지 않는 글자를 원자료와 대조합니다. 손글씨 인식 연구[4]는 중국어·영어 인식 결과의 언어모델 보정을, 정신건강 인터뷰 연구[5]는 전사 서비스별 오류 차이를 다뤘습니다. 한국어 포스트잇과 여러 사람이 함께 말하는 현장의 정확도를 보장하는 근거는 아닙니다.
신호 원장: 원문 한 건과 출처를 연결합니다
신호 원장에는 한 줄에 발언·서술형 응답·관찰 한 건을 기록합니다. 기록 번호, 익명 참가자 번호, 수집 활동, 상황, 원문, 출처 위치, 해석 초안을 남깁니다. 발언과 관찰은 구분하며, 정리자가 재구성한 문장을 직접 발언으로 집계하지 않습니다.
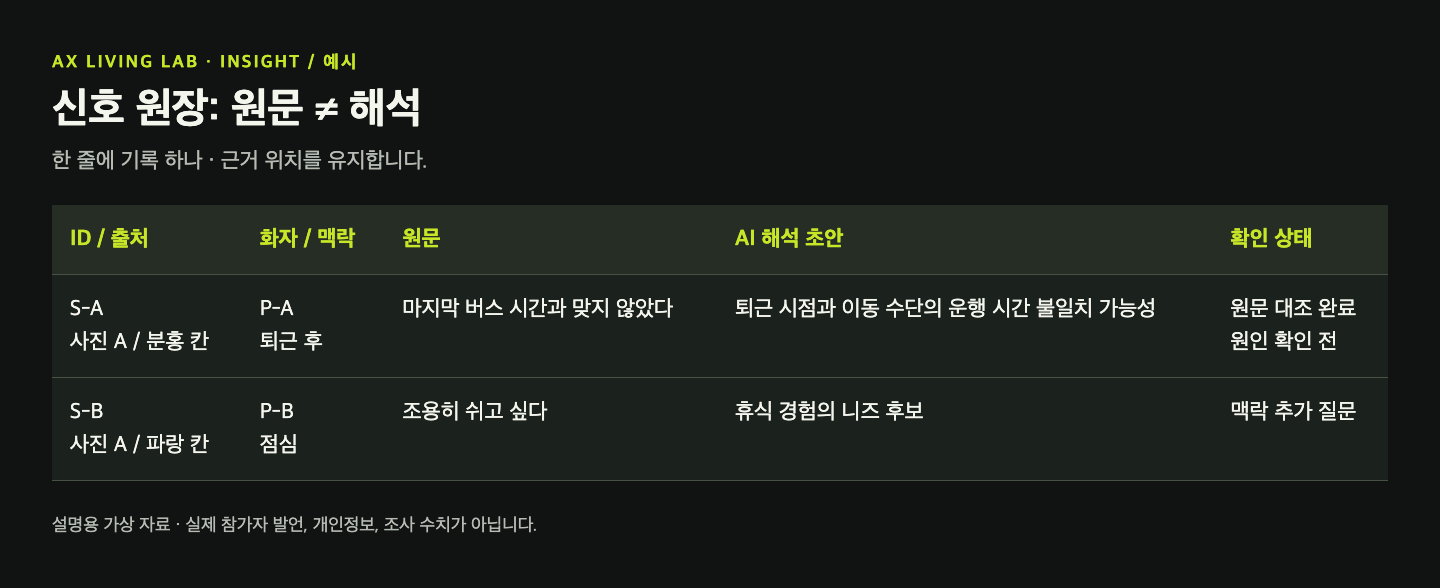
아이디어는 별도 목록에 제안 원문을 보존하고, 유사 묶음과 관련 니즈 번호를 붙입니다. 묶음 제목이 비슷하다는 이유만으로 서로 다른 이용 상황을 합치지 않습니다. 같은 참가자의 반복 발언과 여러 참가자의 의견도 번호로 구분합니다.
AI는 확인된 기록의 분류와 연결 후보를 제안합니다. 사람은 원문 존재 여부와 연결의 타당성을 대조합니다. 번호 발급·필수 항목 점검·연결 누락 검사는 규칙 기반 도구로 처리할 수 있습니다. 분류 기준과 AI 사용 방식도 기록해 해석이 바뀐 이유를 되짚을 수 있게 합니다.
정리 워크숍: 참가자가 니즈의 맞음·다름·누락을 확인합니다
인사이트의 기반이 되는 니즈는 수집 직후의 초안입니다. 정리 워크숍을 반드시 열고, 다음 단계에 전달할 니즈 카드 형식 그대로 참가자에게 제시합니다. 카드에는 누가·어떤 상황에서·무엇을 원하는지, 대표 경험 세 개와 출처 번호, 공감과 다른 의견을 담습니다. 근거가 부족하면 그 상태를 표시합니다.
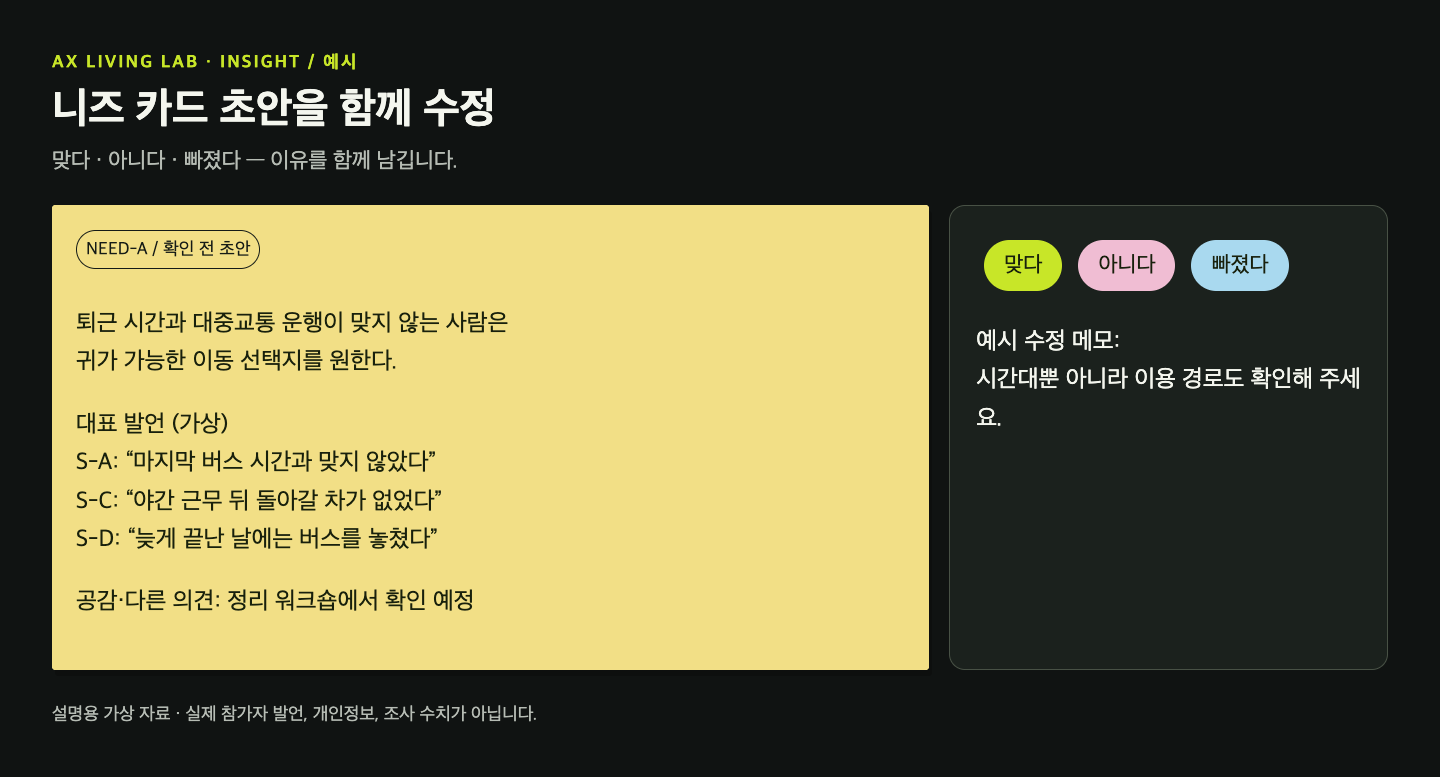
참가자는 “맞다·아니다·빠졌다”와 그 이유를 남깁니다. 의견을 반영한 문장, 수정 사유, 확인 상태를 함께 보존하고 불참자의 의견도 같은 형식으로 받습니다. 환자 연구 참여자의 경험을 다룬 참여형 멤버 체킹 연구[2]를 참고한 구성입니다. 참가자의 동의는 해석을 보완하는 자료이며, 원인 가설의 입증이나 전체 집단의 동의를 뜻하지 않습니다.
AI는 반응과 수정 전후 차이를 정리합니다. 진행자는 발언 기회를 조정하고, 동의뿐 아니라 이견과 누락을 확인합니다.
인사이트: 근거와 반례를 비교해 설계 방향을 제안합니다
인사이트에는 관찰된 패턴·원인 가설·디자인 기회를 구분해 씁니다. 관련 니즈와 근거 기록 번호, 상반된 경험, 적용 조건, 추가 조사 질문을 붙입니다. “교통 불편”이라는 주제명만으로는 어떤 서비스를 설계해야 할지 설명하기 어렵습니다.
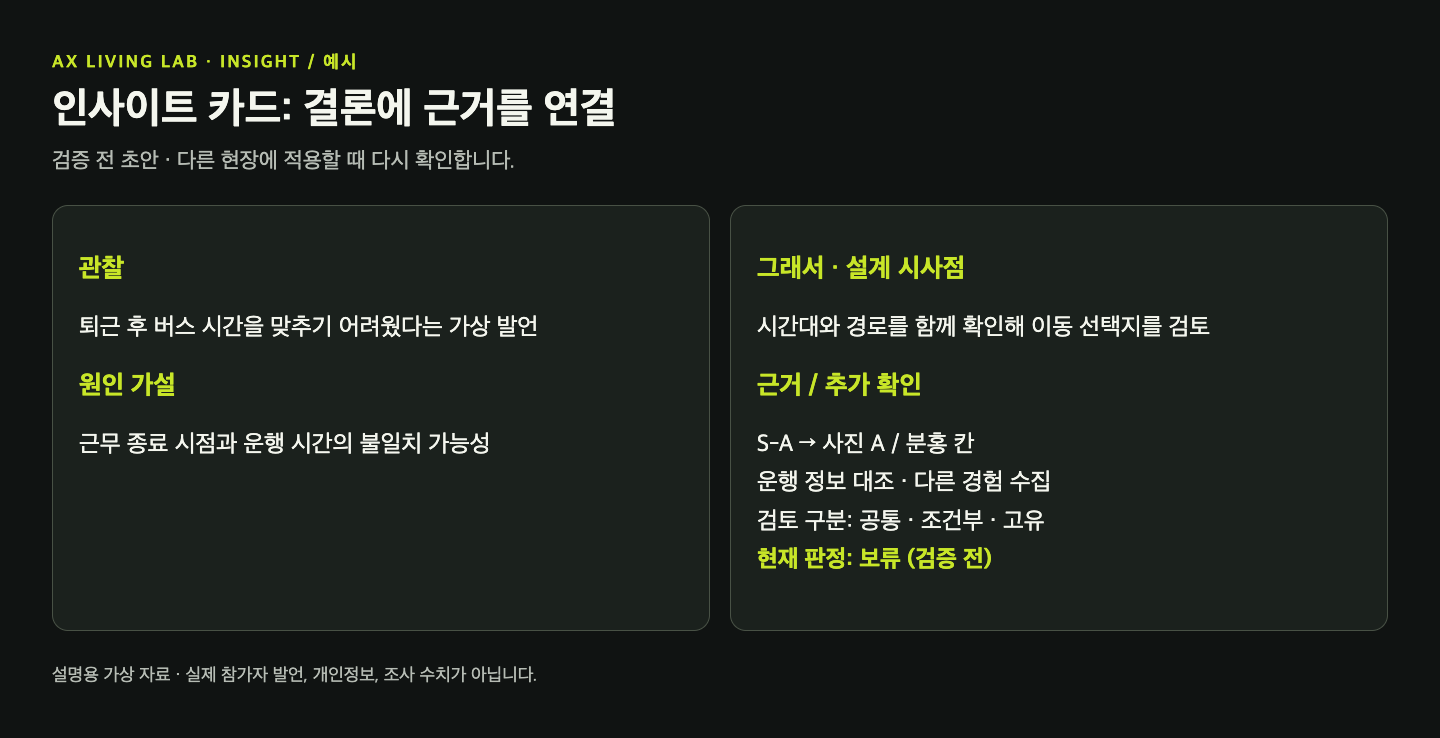
의료 인터뷰를 분석한 연구에서는 GPT-4와 사람이 주요 주제 일부를 함께 찾았지만 세부 주제는 달랐습니다[1]. 이 결과를 서비스디자인 워크숍에 그대로 적용할 수는 없습니다. 저희의 제안은 AI가 여러 해석 후보를 만들고, 연구자가 원문·반례·다른 설명을 대조하는 방식입니다. 예를 들어 야간 귀가 문제는 ‘이동 수단 부족’과 ‘이용 정보 부족’으로 다르게 해석할 수 있습니다. 퇴근 시각·운행 시간·정보 탐색 경험을 비교하고, 두 원인이 함께 작용하는지도 확인합니다. 참가자가 경험을 확인하고 분야 전문가가 맥락을 평가한 뒤, 연구자가 채택·수정·보류 사유를 남깁니다.
전문가 평가는 근거의 충실성·해석의 논리·현장 적합성으로 나눕니다. 필요하면 항목별 전문성에 따라 가중치를 적용하되 기준과 이유를 먼저 정합니다. 해석의 타당성과 실행 우선순위는 별도로 평가하며, 개별 의견과 참가자의 이견을 합산 점수와 함께 보존합니다. 점수는 해석이 사실일 확률이 아니며, 근거가 부족하면 추가 조사를 제안합니다. 이는 검증된 채점 방식이 아니라 저희의 운영 설계 제안입니다.
4. 활용: 확인한 니즈를 서비스 설계와 시험으로 연결합니다
처음부터 별도 시스템을 개발할 필요는 없습니다. 원자료 폴더와 관리표를 함께 운영할 수 있습니다. 사진·녹음·설문 원응답은 보존하고, 관리표에는 원자료 목록·신호 원장·아이디어·니즈·인사이트와 검토 이력을 나눠 기록합니다. 각 후보에는 작성 주체, 근거 번호, 미확인 사항, 검토 상태를 붙이고 평가자 역할과 판단 사유를 연결합니다. 원문은 유지하며 수정된 해석은 버전과 사유를 남깁니다. 공유 범위에 따라 익명화한 자료와 원자료의 접근 권한도 구분합니다.
핵심 연결은 “인사이트 → 니즈 → 경험 기록 → 원자료의 해당 위치”입니다. 보고서 문장을 수정해도 근거 번호는 유지합니다. 대시보드는 이 관리표를 탐색하는 화면이고, 핵심 인사이트 리포트는 검토한 자료를 목적에 맞게 편집한 결과물입니다.
| 다음 작업 | 활용할 자료 | 남기는 결과물 |
|---|---|---|
| 문제 정의 | 니즈와 경험의 맥락 | 문제 정의서·사용자 여정 지도 |
| 콘셉트 선정 | 인사이트, 관련 아이디어, 근거와 반례 | 우선 검토 콘셉트·선정 사유 |
| 서비스 설계 | 선정 콘셉트와 이용 조건 | 서비스 블루프린트·시제품 |
| 현장 검증 | 원인 가설과 아직 모르는 조건 | 검증 보고서·개선 과제·운영안 |
귀가 문제라면 교대조별 여정을 확인하고, 이동 안내와 공동 차량 콘셉트를 비교한 뒤 안내 화면과 예약 절차를 시험합니다. 실제로 이동 수단을 찾고 이용했는지, 이용하지 못했다면 왜 그랬는지 확인합니다. 제안 건수만으로 실행 우선순위를 정하지 않습니다.
5. 범위: 정성 근거와 정량·환경분석을 구분합니다
정성조사는 경험의 맥락과 요구를 파악하는 자료입니다. 발언이 반복됐다는 사실만으로 전체 집단에서의 비율을 산출하지 않습니다. 아이디어 수, 기록 수, 참여자 수, 확인된 니즈 수도 각각 다른 지표로 관리합니다.
정량조사와 환경분석은 별도로 분석한 뒤 관련 니즈·인사이트에 연결합니다. 정량조사는 요구의 분포와 집단 차이를, 환경분석은 교통·시설·정책·기존 서비스 등 실행 조건을 확인하는 데 활용합니다. 서로 다른 결과가 나오면 평균적으로 요약하지 않고 표본·질문·장소·시점의 차이를 검토합니다.
운영에서는 정리 시간뿐 아니라 원문 대조 수정 내역, 출처 연결 누락, 참가자의 이견과 수정 반영, 다음 설계에서의 자료 사용을 살펴봅니다. AI를 도입할 때도 이 항목을 확인해야 합니다. 저희가 제안하는 AX의 변화는 중간 결과물을 근거와 연결하고, 사람이 질문 설계와 해석 검토에 집중하도록 업무를 바꾸는 것입니다.
다음 워크숍을 준비한다면 먼저 세 가지를 정해 보세요. 최종 인사이트에서 어떤 원문으로 돌아갈 수 있어야 하는가? 이를 위해 현장에서 무엇을 기록해야 하는가? 참가자는 언제 어떤 형식으로 해석을 확인할 것인가?
참고문헌
- Li, K. D., Fernandez, A. M., Schwartz, R., Rios, N., Carlisle, M. N., Amend, G. M., Patel, H. V., & Breyer, B. N. (2024). Comparing GPT-4 and Human Researchers in Health Care Data Analysis: Qualitative Description Study. Journal of Medical Internet Research, 26, e56500. DOI
- Kullman, S. M., & Chudyk, A. M. (2025). Participatory Member Checking: A Novel Approach for Engaging Participants in Co-Creating Qualitative Findings. International Journal of Qualitative Methods, 24. DOI
- Ralston, K., Smith, S. E., Kerins, J., Clark-Stewart, S., & Tallentire, V. (2024). Safety on the ground: using critical incident technique to explore the factors influencing medical registrars’ provision of safe care. BMJ Open Quality, 13(1), e002641. DOI
- Li, H., Peng, D., & Jin, L. (2025). EGO-LM: An efficient, generic, and out-of-the-box language model for handwritten text recognition. Pattern Recognition, 159, 111130. DOI
- Seyedi, S., Griner, E., Corbin, L., Jiang, Z., Roberts, K., Iacobelli, L., Milloy, A., Boazak, M., Bahrami Rad, A., Abbasi, A., Cotes, R. O., & Clifford, G. D. (2023). Using HIPAA (Health Insurance Portability and Accountability Act)–Compliant Transcription Services for Virtual Psychiatric Interviews: Pilot Comparison Study. JMIR Mental Health, 10, e48517. DOI